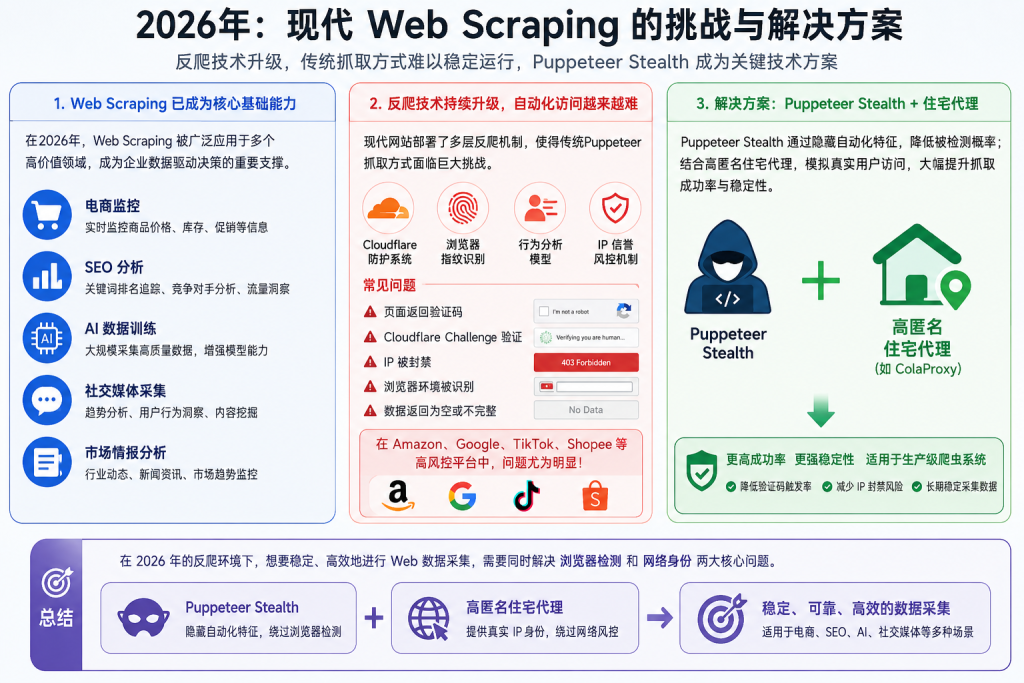
在2026年,Web Scraping(网页数据抓取)已经成为电商监控、SEO分析、AI数据训练、社交媒体采集以及市场情报分析等领域的重要基础能力。然而,随着网站反爬技术持续升级,现代平台普遍引入了Cloudflare防护系统、浏览器指纹识别、行为分析模型以及IP信誉风控机制,使得自动化访问变得越来越困难。
在这种环境下,传统的Puppeteer抓取方式已经很难稳定运行。开发者经常会遇到页面返回验证码、Cloudflare Challenge验证、IP被封禁、浏览器环境被识别或数据返回为空等问题,尤其是在Amazon、Google、TikTok和Shopee等高风控平台中更为明显。
因此,Puppeteer Stealth逐渐成为现代Web Scraping的重要技术方案之一。而当它与高匿名住宅代理(例如ColaProxy Residential Proxies)结合使用时,可以显著提升数据采集的成功率与稳定性,使其更适用于生产级爬虫系统。
什么是 Puppeteer Stealth?
该插件本质上是基于puppeteer-extra-plugin-stealth的浏览器反检测插件,它的主要作用是隐藏Puppeteer自动化特征,使浏览器行为更接近真实用户,从而降低被网站识别为机器人流量的概率。
在默认情况下,Puppeteer浏览器会暴露多种自动化痕迹,例如navigator.webdriver = true、Headless模式特征、Canvas指纹异常、WebGL渲染差异、字体信息缺失以及插件环境不完整等。这些特征在现代反爬系统中很容易被识别。
该隐身方案的核心作用是对这些浏览器特征进行修复与伪装,使浏览器环境看起来更自然、更接近真实用户设备。
为什么2026年的网站更容易识别爬虫?
现代反爬系统已经不再依赖单一规则,而是采用多维度机器学习模型进行综合判断。换句话说,它们不是“看一个特征”,而是“分析整个行为生态”。
目前主流检测维度包括IP信誉评分、浏览器指纹一致性、用户行为轨迹、TLS/JA3网络指纹、WebRTC泄露情况、会话Cookie行为以及请求频率模式等多个层级。
这意味着,仅仅更换IP或使用无头浏览器已经远远不够。即使浏览器层面完全隐藏自动化特征,如果IP来源异常或行为模式不自然,依然会被识别并拦截。
典型风控检测维度对比
| 检测层级 | 检测内容 | 风险等级 |
|---|---|---|
| IP信誉系统 | 数据中心 / VPN / 代理识别 | 极高 |
| 浏览器指纹 | Canvas / WebGL / Fonts | 高 |
| 行为分析 | 滚动 / 点击 / 停留时间 | 中 |
| TLS指纹 | 网络握手特征识别 | 高 |
| 会话分析 | Cookies与登录行为 | 高 |
| 请求频率 | 访问节奏是否异常 | 中 |
浏览器隐身机制如何工作?
该反检测插件通过修改浏览器运行时环境,使其更接近真实用户,从而降低被检测概率。它并不是改变爬虫逻辑,而是“伪装浏览器身份”。
在实际运行过程中,它主要优化以下几个关键点。
首先是隐藏navigator.webdriver字段,这是最常见的自动化识别方式之一。其次是模拟真实浏览器插件环境,例如PDF Viewer和Chrome内置组件,使浏览器结构更加完整。同时,它还会修复Headless Chrome暴露的特征,并优化Canvas和WebGL指纹,使渲染结果更接近真实设备。
基础使用示例
const puppeteer = require('puppeteer-extra')
const StealthPlugin = require('puppeteer-extra-plugin-stealth')

puppeteer.use(StealthPlugin())

async function run() {
    const browser = await puppeteer.launch({
        headless: true
    })

    const page = await browser.newPage()

    await page.goto('https://bot.sannysoft.com')

    console.log(await page.title())

    await browser.close()
}

run()
为什么隐身浏览器仍然可能被封锁?
一个常见误区是:只要使用Stealth插件就不会被封锁。但在实际环境中,这种理解是不完整的。
Stealth仅解决浏览器层问题,但无法处理网络层风险。例如IP信誉、代理类型、地理位置异常以及请求频率依然会直接影响访问结果。
尤其是在Google SERP、Amazon商品页或TikTok数据流中,平台会同时分析浏览器行为与网络来源,如果IP来自高风险数据中心,即使浏览器完全正常,也可能立即触发封锁机制。
为什么住宅代理在Scraping中越来越重要?
在2026年,IP信誉已经成为反爬系统的核心判断标准之一。网站可以轻松识别流量是否来自云服务器、VPN或数据中心IP。
相比之下,住宅代理使用的是来自真实家庭网络的IP地址,从访问来源上更接近普通用户,因此在反爬系统中具有更高的信任评分。
代理类型对比
ColaProxy如何提升Puppeteer Stealth成功率?
ColaProxy提供全球高匿名住宅代理网络,专为浏览器自动化与大规模数据采集设计。在浏览器隐身抓取环境中,它主要解决的是“网络身份可信度问题”。
通过真实ISP住宅IP,ColaProxy可以显著降低验证码触发率,提高会话稳定性,并减少IP封禁风险。对于需要长期运行的数据采集任务,例如电商监控、SEO分析或社交媒体数据抓取,这种稳定性尤为重要。
ColaProxy核心能力总结
| 功能 | 优势 |
|---|---|
| 9000万+住宅IP | 全球覆盖 |
| 动态IP轮换 | 降低封禁率 |
| 高匿名连接 | 更接近真实用户 |
| 多地区支持 | 全球数据采集 |
| 长会话稳定 | 支持登录型抓取 |
| 高并发能力 | 企业级扩展 |
Puppeteer + ColaProxy 实战示例
const puppeteer = require('puppeteer-extra')
const StealthPlugin = require('puppeteer-extra-plugin-stealth')

puppeteer.use(StealthPlugin())

async function run() {
    const browser = await puppeteer.launch({
        headless: true,
        args: [
            '--proxy-server=http://proxy.colaproxy.com:9000'
        ]
    })

    const page = await browser.newPage()

    await page.authenticate({
        username: 'your-username',
        password: 'your-password'
    })

    await page.goto('https://www.google.com')

    console.log(await page.title())

    await browser.close()
}

run()
Web Scraping的真实应用场景(Google & Amazon为核心)
在实际业务中,Web Scraping并不仅仅是技术行为,而是企业数据战略的一部分。尤其是在Google SERP和Amazon平台中,数据采集已经成为竞争分析的关键工具。
在Google SERP场景下,开发者通常会通过抓取搜索结果来分析关键词排名变化、SEO优化效果以及竞争对手的内容策略。这类数据对于SEO团队和数字营销公司至关重要,因为它直接影响网站流量增长策略。
而在Amazon场景中,Scraping更多用于产品价格监控、评论分析以及竞品追踪。例如,商家可以通过持续采集产品列表数据,实时监控价格变化,从而调整自身定价策略,提升市场竞争力。
除此之外,在TikTok和社交媒体领域,Web Scraping被广泛用于趋势分析与内容挖掘,帮助品牌识别热门话题与用户兴趣变化。而在AI领域,大规模网页数据更是模型训练的重要来源之一。
为什么这些场景更容易被封?
Google和Amazon之所以难以抓取,是因为它们部署了多层反爬机制。
例如,Google会根据用户行为轨迹判断访问是否自然,包括搜索节奏、页面停留时间以及点击路径。而Amazon则更严格,会直接结合IP信誉、设备指纹以及账号行为进行综合评分。
一旦系统检测到异常行为,例如短时间内大量请求、IP频繁切换或浏览行为过于规律,就会触发验证码或直接封禁访问。
Cloudflare 为什么会拦截自动化浏览器?
在现代Web Scraping环境中,Cloudflare已经成为最常见的反爬系统之一。它不仅会检测IP信誉,还会分析浏览器指纹、TLS特征以及页面交互行为。
当系统发现访问请求来自异常数据中心IP、Headless浏览器或高频自动化行为时,就会触发Cloudflare Challenge验证。常见表现包括无限验证码循环、403 Forbidden、JavaScript Challenge以及页面重定向。
对于Google SERP与Amazon等高风控平台来说,Cloudflare风控机制往往会结合行为分析模型一起工作,因此仅依赖普通代理或默认浏览器环境已经难以稳定运行。
目前较稳定的解决方案通常会结合浏览器隐身技术、高匿名住宅代理以及行为模拟机制,通过降低自动化特征暴露程度来提升数据采集稳定性。
为什么住宅代理是关键解决方案?
在这种环境下,仅依赖Puppeteer Stealth已经无法保证稳定性,因为浏览器层伪装无法改变网络层身份。
住宅代理的作用是提供真实ISP分配的IP地址,使请求看起来像普通用户访问,而不是自动化脚本。这种“身份真实性”在Google和Amazon系统中具有更高的信任评分。
尤其是在使用高质量住宅代理时,可以显著降低验证码触发率,同时提高长期会话稳定性,使大规模数据采集成为可能。
Web Scraping最佳实践(2026)
在现代反爬环境中,稳定的爬虫系统通常需要遵循以下原则:
首先避免使用默认User-Agent,而是模拟真实设备环境,例如Chrome不同版本与操作系统组合。其次控制请求频率,避免短时间内大量访问目标网站。同时建议使用住宅代理进行IP轮换,避免会话关联风险。此外,通过模拟真实用户行为,例如滚动、点击延迟与输入节奏,可以显著降低行为检测风险。
未来趋势:AI + Browser Automation
随着AI Agent技术发展,越来越多系统开始结合Puppeteer或Playwright进行自动化数据采集与网页操作。这意味着未来的Web Scraping将不仅仅是数据抓取,而是AI驱动的自动决策系统。
在这一趋势下,代理IP基础设施将成为AI系统的重要组成部分,而住宅代理网络将成为支撑大规模自动化访问的关键资源。
总结
随着2026年反爬技术进入AI驱动阶段,Web Scraping的竞争已经不再是单纯的代码能力,而是整体基础设施能力的竞争。
浏览器自动化工具(如Puppeteer Stealth)只能解决“可见层伪装”,而真正决定成功率的核心因素来自网络身份与IP信誉体系。
因此,在Google SERP、Amazon等高风控平台中,只有将浏览器隐身技术与高质量住宅代理基础设施结合,才能构建长期稳定的数据采集能力。